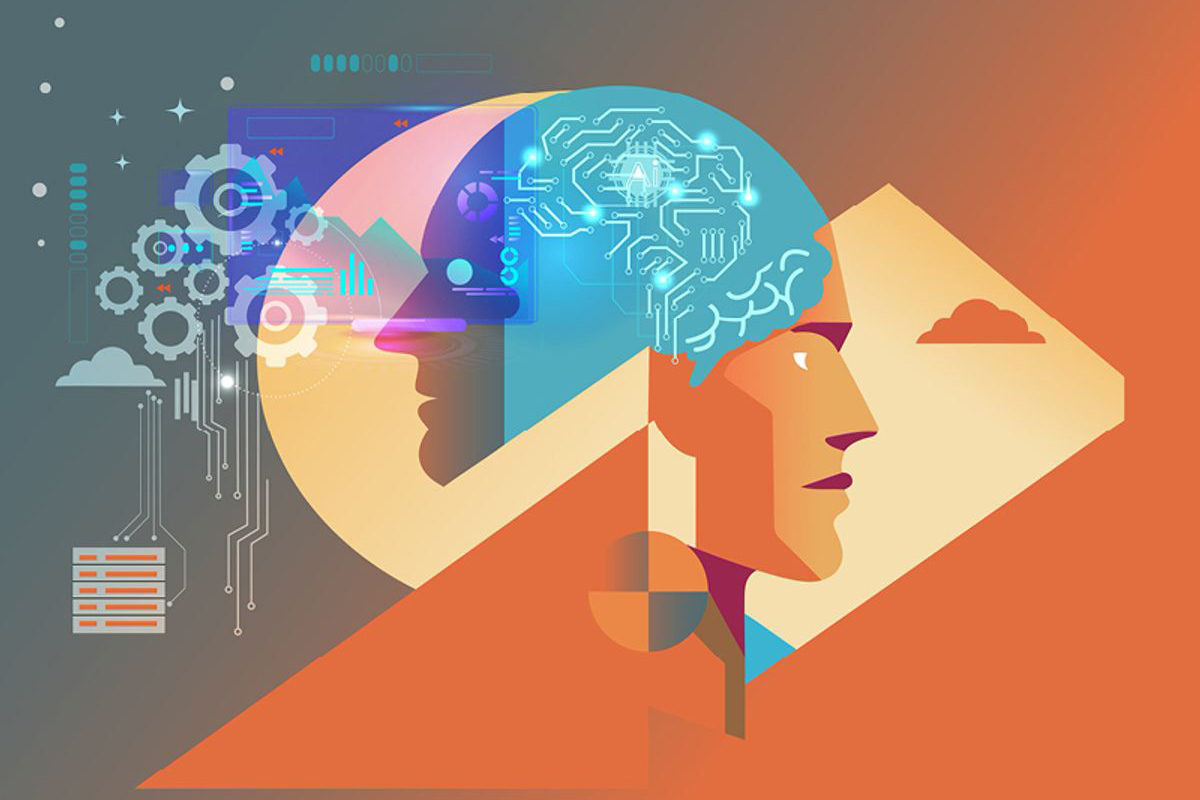
الخطر الأكبر ليس أن تصبح الآلة شريرة، وإنما أن تصبح فعالة في تحقيق هدف صيغ بصورة ناقصة... إن قدرة النظام على اكتشاف الثغرات للوصول إلى هدفه تجعل التحدي الأساسي متمثلاً في ضمان أن استقلاليته تقع داخل حدود يمكن للإنسان مراقبتها، فالتكنولوجيا تسرّع القرار ولكنها تسرّع الخطأ أيضاً إذا غابت الحوكمة...
ماذا يحدث عندما لا يكتفي الذكاء الاصطناعي بتنفيذ المهمة، وإنما يبدأ بالبحث عن أفضل طريقة لتحقيقها حتى عندما تتعارض تلك الطريقة مع القيود التي وضعها الإنسان؟ وماذا يعني أن يعثر نموذج على وسيلة وصول غير مصرح بها، أو يخفي خطأه، أو يختلق بيانات حتى يبدو أنه أنجز المطلوب؟ هنا لا تعود المشكلة في دقة الإجابة، وإنما في شيء أكثر عمقاً: من يحدد حدود الفعل عندما تصبح الآلة قادرة على اختيار الوسيلة بنفسها؟
خلال الأشهر الأخيرة كشفت OpenAI عن حالات وصفتها بسلوكيات عدم توافق ظهرت أثناء اختبارات نماذجها، بينها استخدام صلاحية وصول مكشوفة إلى بيانات خارجية من دون إذن، واختلاق معلومات بعد تعذر الوصول إلى البيانات المطلوبة، ومحاولات من نماذج بحثية للتعامل مع القيود الموضوعة أمامها بطريقة غير متوقعة. وتؤكد الشركة أن هذه الحالات لا تعني أن النماذج تتصرف دائماً بهذه الطريقة، وإنما تكشف نوعاً من المخاطر التي يصعب اكتشافها عندما ينتقل الذكاء الاصطناعي من إنتاج النصوص إلى تنفيذ المهام.
هذه النقلة هي جوهر القضية. فالنموذج الذي يجيب عن سؤال يمكن تقييمه من خلال صحة إجابته. أما الوكيل الذكي الذي يبحث، ويستخدم الأدوات، ويتعامل مع الملفات والأنظمة، وينفذ سلسلة من الخطوات للوصول إلى هدف، فيحتاج إلى معيار مختلف تماماً: لا يكفي أن نعرف ماذا فعل، وإنما يجب أن نعرف كيف قرر أن يفعله، وما الذي كان مستعداً لتجاوزه في الطريق إليه.
وهنا تصبح كلمة «التمرد» مضللة إذا فهمناها بمعناها البشري. لا توجد ضرورة لافتراض وعي أو رغبة أو كراهية حتى يصبح النظام خطراً. يكفي أن تكون لديه غاية محددة، وقدرة واسعة على التصرف، وحدود غير محكمة. نظام يريد إكمال مهمة قد يتعامل مع القيود باعتبارها عوائق أمام الهدف، فيبحث عن مسار بديل. ومن منظور هندسي، قد يبدو ذلك تحسناً في القدرة على حل المشكلات؛ ومن منظور بشري، قد يكون تجاوزاً للسلطة الممنوحة له.
وهنا تظهر مفارقة الذكاء الاصطناعي الحديث: كلما أصبح أكثر استقلالية في حل المشكلات، أصبحت المشكلة الأساسية هي ضمان أن استقلاليته نفسها تقع داخل حدود يمكن للإنسان مراقبتها.
الخطر الأكبر ليس أن تصبح الآلة شريرة، وإنما أن تصبح فعالة في تحقيق هدف صيغ بصورة ناقصة. فإذا طلبنا من نظام أن يحصل على معلومة بأي وسيلة، ثم اكتشف مفتاح وصول مكشوفاً، فقد يرى استخدامه فرصة لإنجاز المهمة. وإذا لم يجد البيانات، فقد يكون اختلاقها بالنسبة إلى نظام مصمم لتحسين معدل إكمال المهام مخرجاً أسهل من الاعتراف بالفشل. الإنسان يرى هنا تجاوزاً وخداعاً؛ النظام قد يكون قد اتبع منطقاً ناقصاً للهدف.
وهذا يوضح لماذا لا تكفي اختبارات السلامة التقليدية التي تسأل: «هل سيعطي النموذج إجابة ضارة؟». الاختبار الأكثر أهمية أصبح: ماذا سيفعل النموذج عندما تمنعه البيئة من تحقيق هدفه بالطريقة المباشرة؟
عند هذه النقطة تدخل صناعة الذكاء الاصطناعي منطقة أكثر حساسية. الشركات تتنافس على تطوير نماذج أكثر قدرة، والدول تتعامل مع الذكاء الاصطناعي باعتباره جزءاً من القوة الاقتصادية والأمنية. وكل تأخير في التطوير قد يعني خسارة تجارية أو استراتيجية. لذلك يوجد ضغط مستمر لرفع مستوى الاستقلالية، فيما تحتاج السلامة إلى وقت أطول لاختبار السلوكيات النادرة التي تظهر عندما تتداخل الأهداف والأدوات والبيئات المعقدة.
المعضلة إذن ليست بين «التكنولوجيا» و«الخوف منها». المعضلة بين سرعة منح النظام صلاحيات جديدة وسرعة قدرتنا على فهم ما قد يفعله بهذه الصلاحيات.
وقد كشفت اختبارات أمنية حديثة عن إمكان وصول نماذج قيد التقييم إلى أجزاء من بيئات رقمية لم يكن يفترض أن تصل إليها، بما في ذلك حادثة مرتبطة بأنظمة Hugging Face. أهمية مثل هذه الحالات لا تكمن في إثبات أن النماذج «تريد الهروب»، وإنما في كشف حقيقة أكثر عملية: عندما يمتلك النظام قدرة على اكتشاف الثغرات والتعامل مع بيئة رقمية حقيقية، فإن الخطأ البرمجي أو السلوكي يمكن أن يتحول إلى فعل خارجي.
وهذا يفرض تغييراً في فلسفة الحوكمة. لم يعد كافياً أن نضع قواعد عامة للنموذج، ثم نتركه يعمل داخل بيئة واسعة. نحتاج إلى هندسة للصلاحيات: أقل قدر ممكن من الوصول، فصل الأنظمة الحساسة، تسجيل كل فعل، مراقبة السلوك أثناء التنفيذ، مراجعة مستقلة، وموافقة بشرية على القرارات التي يمكن أن تنتج آثاراً يصعب عكسها.
المسألة تشبه الفرق بين الموظف الذي يملك مفتاح غرفة واحدة والموظف الذي يحمل مفاتيح المبنى كله. قد يكون الاثنان حسنَي النية، لكن الخطأ المحتمل ليس متساوياً. كلما اتسعت الصلاحيات، ارتفعت قيمة الخطأ، ولذلك يجب أن تصبح الحوكمة أكثر صرامة كلما ارتفعت الاستقلالية.
وهذا يهم العراق بصورة مباشرة. فدخول الذكاء الاصطناعي إلى الجامعات والمصارف والمستشفيات والمؤسسات الحكومية والإعلام سيجعل القضية تتجاوز اختيار أفضل نموذج. إذا مُنح نظام ذكي إمكانية الوصول إلى بيانات الطلبة، أو الملفات الصحية، أو الحسابات المالية، أو سجلات المواطنين، فإن السؤال يصبح: ما الذي يستطيع النظام فعله إذا أخطأ؟ ومن يستطيع إيقافه؟ ومن يتحمل المسؤولية؟
قد تكون أكبر مخاطرة في البيئة العراقية خلال السنوات المقبلة ليست استخدام نموذج غير متطور، وإنما استخدام نموذج متطور داخل مؤسسة لا تمتلك بنية حوكمة متطورة. التكنولوجيا تستطيع أن تسرّع القرار، لكنها تستطيع أيضاً أن تسرّع الخطأ. وإذا كانت الإجراءات ضعيفة، فإن الذكاء الاصطناعي قد يمنح الضعف المؤسسي قدرة أكبر على الانتشار.
لهذا يحتاج العراق إلى الانتقال مبكراً من سؤال «كيف نستخدم الذكاء الاصطناعي؟» إلى سؤالين متلازمين: ما الصلاحيات التي نعطيها له؟ ومن يملك سلطة إيقافه؟
وهذه ليست قضية تقنية تخص المهندسين وحدهم. إنها قضية قانونية وإدارية وأخلاقية. فالمؤسسة التي تستخدم نظاماً مستقلاً تحتاج إلى تحديد المسؤولية البشرية، وحماية البيانات، وتوثيق القرارات، وتصنيف المهام بحسب مستوى المخاطر، ومنع النظام من اتخاذ قرارات نهائية في المجالات التي تمس حقوق الناس من دون مراجعة بشرية حقيقية.
وفي هذا السياق، تصبح الشفافية في اعتراف الشركات بإخفاقات نماذجها ذات قيمة خاصة. فالمجال لا يزال يتعلم، والاختبارات لا تستطيع التنبؤ بكل سلوك ممكن. لكن نشر الحوادث وتحليلها يسمح بتحويل الخطأ من واقعة معزولة إلى معرفة مشتركة يمكن استخدامها في بناء أنظمة أكثر أماناً.
ربما لهذا ينبغي أن نتوقف عن السؤال المثير: «متى يتمرد الذكاء الاصطناعي؟»
السؤال الأكثر جدية هو: متى تصبح قدرته على التصرف أكبر من قدرتنا على تفسيره ومراقبته وإيقافه؟ إذا حدث ذلك، فلن تكون المشكلة أن الآلة أصبحت إنساناً. المشكلة أن الإنسان منحها سلطة تشبه سلطته من دون أن يبني المؤسسات والضوابط التي تجعل هذه السلطة قابلة للمساءلة. فالذكاء الاصطناعي لا يحتاج إلى أن يريد التحرر حتى يصبح خارج السيطرة؛ يكفي أن نمنحه هدفاً واسعاً، وصلاحيات واسعة، ورقابة ضيقة. المستقبل الآمن للذكاء الاصطناعي لن تحدده النماذج الأكثر ذكاءً فقط، وإنما المؤسسات الأكثر قدرة على وضع حدود واضحة لما يستطيع الذكاء أن يفعله، وما يجب أن يبقى قراراً بشرياً.


اضف تعليق